Зачем сайту llms.txt и как его собрать
Когда о вас или продукте спрашивают AI-агента, он не считывает композицию страницы и не догадывается, какие факты важнее. llms.txt и связанный с ним профиль дают ему короткую, проверяемую точку входа. Это не замена сайту, SEO или документации — а способ сделать уже существующую информацию понятнее машине.
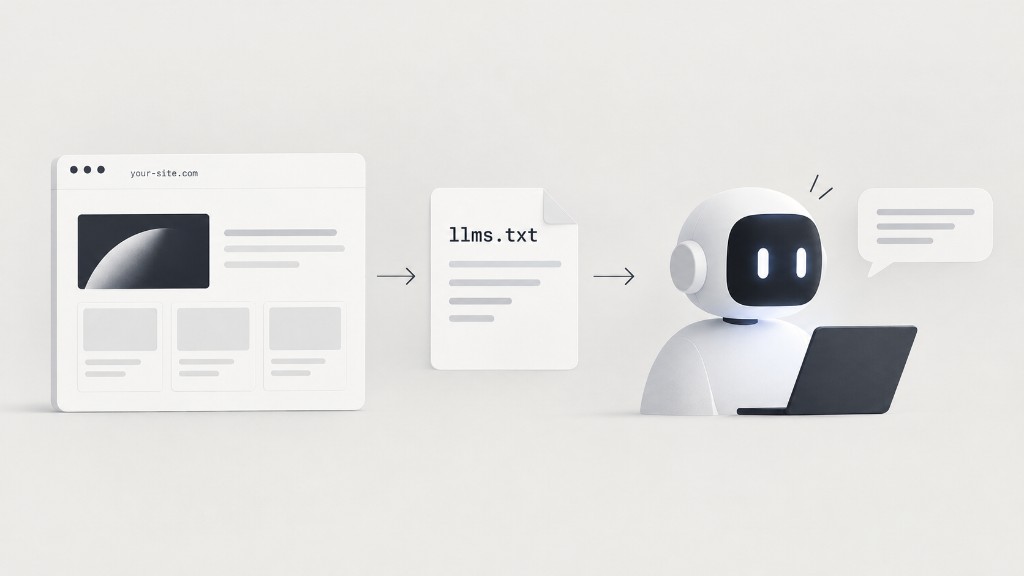
У сайта появился ещё один читатель. Не тот, кто открывает страницу, замечает крупный заголовок, смотрит на кейс и за пару секунд понимает, чем занимается автор. Этот читатель приходит по запросу: «кто это?», «какой инструмент выбрать?», «где документация?» — и пытается собрать ответ из HTML, ссылок, сниппетов и доступных ему файлов.
Это AI‑агент. Он уже ищет информацию, сравнивает продукты, читает документацию, готовит черновики и передаёт человеку ссылки. И делает это не так, как мы читаем сайт глазами.
Хорошая страница не всегда понятна агенту
Человек быстро считывает контекст из формы. Он видит, что «Проекты» — это раздел, карточка — отдельный кейс, а большая цифра рядом с логотипом — скорее всего результат работы. Он понимает иронию, замечает, что старый пост уже не актуален, и может открыть соседнюю вкладку, если не хватает деталей.
Агенту доступна другая версия той же страницы: текст в DOM, метаданные, ссылки и то, что удалось извлечь за один или несколько запросов. Если ответ на важный вопрос размазан между главной, тремя кейсами и профилем в соцсети, модель может не найти его вовсе — или уверенно склеить неточный пересказ.
Проблема не в том, что агент «плохо читает». Просто визуальная иерархия — очень плотный способ передать смысл человеку. Машине нужны более явные опоры: кто говорит, что именно делает, какие утверждения можно повторять и куда идти за деталями.
Что такое llms.txt
llms.txt — это короткий текстовый файл в корне сайта. Его идея похожа на robots.txt или sitemap.xml: дать машине понятную точку входа. В нём можно назвать сайт, объяснить его назначение и дать ссылки на несколько наиболее полезных страниц или более подробный профиль.
Важно не приписывать формату лишнего. Это не общепринятый обязательный стандарт, не кнопка «попасть в ответы ChatGPT» и не замена нормальному HTML, SEO или документации. Разные агенты и краулеры могут его не искать или не переходить по всем ссылкам. Но когда инструмент умеет его читать, файл снимает с него лишнюю работу по догадкам.
На своём сайте я сделал два уровня:
llms.txt— короткий вход: кто я, чем занимаюсь, где проекты, статьи, GitHub и контакты.llm.md— подробный профиль: опыт, принципы работы, выбранные инструменты, ссылки и правила атрибуции.
Такой раздел не конкурирует с главной страницей. Главная помогает человеку почувствовать контекст. Профиль помогает агенту не потерять его по дороге.
Что туда писать
Полезный файл не пытается пересказать весь сайт. Его задача — ответить на базовые вопросы до того, как агент начал строить версию сам:
- кто автор, команда или организация;
- чем они занимаются сейчас и в каком контексте это важно;
- какие проекты или страницы считать источниками правды;
- какие формулировки допустимо использовать в коротком описании;
- как связаться и какие публичные ссылки актуальны.
Для портфолио это может быть профессиональное описание, опыт, несколько кейсов и контакты. Для продукта — назначение, ключевые сценарии, документация, API и страница статуса. Для open‑source — README, установка, поддерживаемые версии, репозиторий и лицензия.
Главное правило — писать только то, что можно проверить по сайту или публичным источникам. Не нужны «лидер рынка», «революционный продукт» и прочие фразы, которые агент потом разнесёт как факт. Лучше конкретная роль, ссылка и граница утверждения.
Это задача не только для личного сайта
Личный сайт — удобный маленький пример, но смысл шире. Любая система, с которой должен работать агент, выигрывает от явного контекста. Мы уже давно делаем это в дизайн‑системах: не надеемся, что разработчик угадает смысл по картинке компонента, а описываем состояния, токены, API и ограничения.
Сайт — такая же система. У него есть сущности, актуальные версии, публичные обещания и маршруты к источникам правды. Если всё это существует только в голове автора и в красивой композиции, человек ещё разберётся. Агенту придётся импровизировать.
Поэтому хороший вопрос не «нужен ли каждому сайту llms.txt?». Небольшой лендинг с одной формой вряд ли выиграет от ещё одного файла. Лучше спросить иначе: есть ли у сайта важный контекст, который машина должна воспроизвести без догадок? Если да — его стоит собрать.
Файл — только начало
Сам по себе llms.txt ничего не исправит. Он не заменит понятные заголовки, хорошие метаданные, работающие ссылки, доступный HTML и актуальную документацию. Если сайт противоречит собственному профилю, агенту станет не легче, а сложнее.
Но как дисциплина этот маленький файл полезен уже сегодня. Он заставляет сформулировать, что именно о вас, продукте или проекте должен понять новый тип читателя. А когда это сформулировано для машины, людям обычно тоже становится понятнее.
Раньше мы проектировали страницу так, чтобы человек быстро понял, куда смотреть. Теперь стоит ещё подумать, что должен понять агент, когда на странице смотреть некому.